
前沿实验室怎么说:用 AI 提升企业效率的方法与证据
综述 Anthropic、OpenAI、xAI、Google 和各家 neo lab 的官方博客,整理企业用 AI 提效的做法;neo lab 部分只收有独立证据的案例。新增一节谈多智能体和长时间运行的智能体:何时值得用、怎么部署、怎么记账。
本文目录
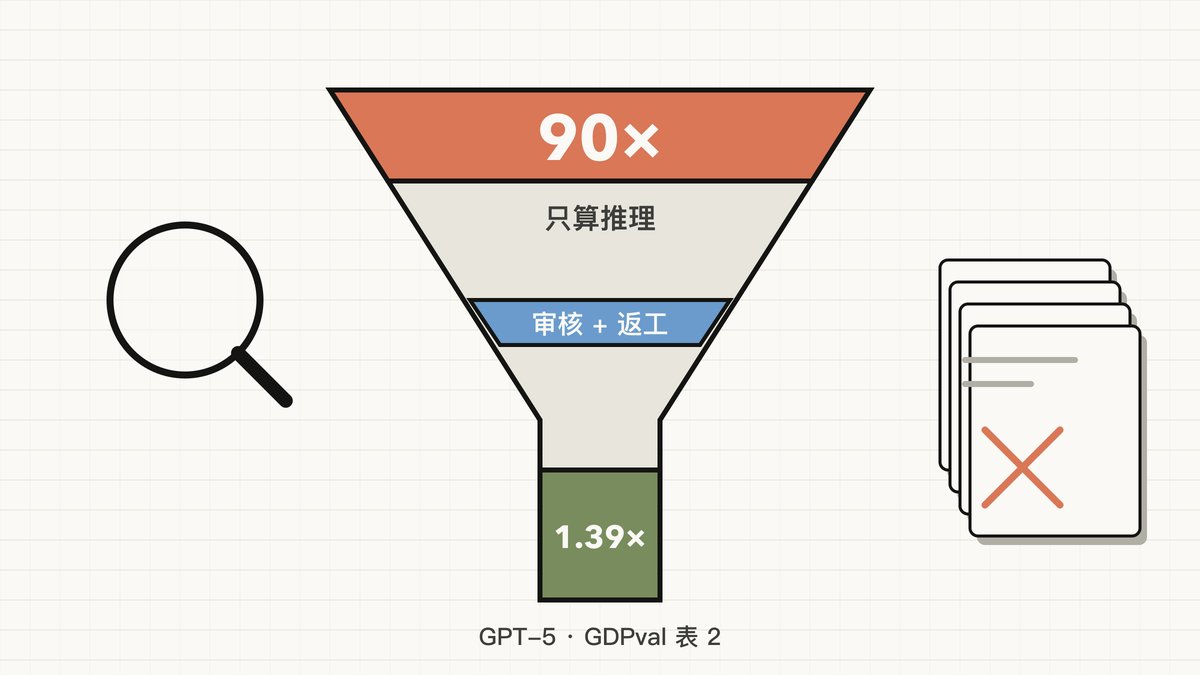
OpenAI 在 2025 年 9 月发布了一个叫 GDPval 的评测,让模型去做专业人士的活儿。发布文章里有一句很抓眼的话:前沿模型完成这些任务,比行业专家快约 100 倍,也便宜约 100 倍。但同一篇文章里还有一句小字,说这个数字只算了模型推理的时间和 API 的价格,没有算人工监督。论文第 15 页的表 2 把审核和返工也算进去之后,GPT-5 的速度优势从 90 倍掉到了1.39 倍。
我读完几家实验室的官方文章,最大的感受就是这个:同一件事,换一种算法,数字能差出两个数量级。公司里想推 AI 的人,往往拿到手的是第一种数字,但真正落地以后过的是第二种日子。所以这篇文章不打算复述各家发了什么新闻,而是想回答三个问题:AI 到底在哪些活儿上见了效,这些公司是怎么做的,效果又该怎么量才不容易被数字骗到。
先交代一下我是怎么读的。2026 年 10 月 20 日这天,我读了 Anthropic、OpenAI、xAI 和 Google 的官方博客、研究报告和客户案例,又查了十几家 neo lab 的官网和外部报道。文中每个数字都链到文末的参考条目,参考条目再指向原文的具体段落和存档。厂商的数字更新得很快,真要引用,最好回原文再看一眼。
我怎么挑来源
Anthropic、OpenAI 和 xAI 的官方博客、研究报告和客户案例,我直接采用,照常注明出处。不过这些数字终究出自厂商,所以正文里我会尽量交代每个数字是怎么来的:问卷自报的,模型估算的,用量统计的,还是真的量出来的。
Google 的情况稍微复杂。Gemini、Google DeepMind 和 Google Research 三个博客里的方法和研究结论,我直接引用;但 Google 转述的客户提效数字,我一律写成“Google 称”,只有找到客户本人或第三方的佐证,才当作事实写。另外,Google Brain 现在已经不是独立团队了:2023 年 4 月 20 日,Sundar Pichai 宣布把 Google Research 的 Brain 团队和 DeepMind 合并,成立 Google DeepMind。所以后文只提 Google DeepMind 和 Google Research。xAI 的网站现在以 SpaceXSI 的名义发文,我仍然沿用 xAI 这个名字。
neo lab 我定得最严。这里说的 neo lab,指 2017 年以后成立、自己训练基础模型、又不隶属于上面四家或其他大型科技公司的 AI 实验室;Cohere 和 AI21 成立得早一些,但业务完全面向企业,也一并收入。一条效果数字要被我当成事实,至少得有下面四种证据之一:客户自己署名发布的数据,上市公司的财报或监管文件,同行评审或可复现的独立评测,可信媒体的独立报道。只在 neo lab 自家博客和新闻稿里出现的说法,我放进文末的一张“只有自述”的表里,写明为什么不采信。
AI 被拿去做什么
先看企业员工实际拿 AI 做什么。Anthropic 2026 年 6 月的报告统计了工作类对话的产出,最常见的是文档和报告(20%)、解释(9%)和邮件草稿(7%)。OpenAI 统计消费者版 ChatGPT 里的工作消息,写作占了 40%。通过 API 接入的企业又不太一样:Anthropic 发现 API 对话里77% 是自动化,只有 12% 是增强,也就是说企业在 API 上更习惯把一整件事交给模型,而不是跟模型一来一回地商量。
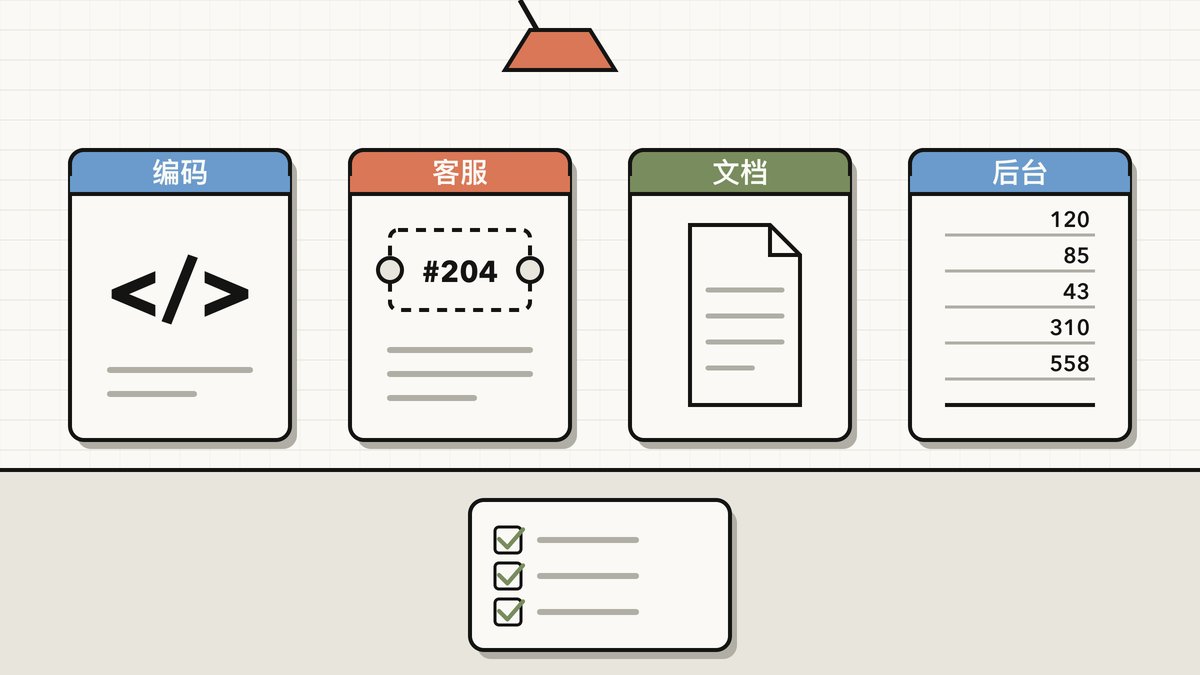
把各家案例摊开看,有证据的活儿大致集中在四类:写代码,处理客服工单,查文档和审合同,还有开票、对账、采购这类后台流程。它们有个共同点:结果比较容易检查。Anthropic 的工程师就说过,他们最先交给 Claude 的,是容易验证的任务。
写代码:证据最扎实
在我读到的材料里,只有编码同时有内部实测和随机对照试验。
Anthropic 在 2025 年 8 月调查了 132 名工程师和研究员,受访者自报 Claude 承担了约 60% 的工作,生产率提高 50%。自报当然靠不住,但 Anthropic 拿出了另一组实测数据来对照:推广 Claude Code 之后,工程团队每人每天合并的 PR 增加了 67%。受访者还估计,有 27% 的 Claude 辅助工作,原本根本不会去做。这一点值得想一想:一部分收益不是把旧活干得更快,而是让原来没人顾得上的活有人干了。
在 Claude Code 里,79% 的对话带有某种自动化,Claude.ai 上只有 49%。另一项研究发现,人大约做了 70% 的规划决策,执行决策只占 20%,也就是人定做什么,模型管怎么做。落到具体案例,Stripe 用 4 天把 1 万行 Scala 代码迁移到了 Java,按 Anthropic 的说法,人工估计要 10 个工程周;Cisco 用 Codex 优化构建,构建时间缩短约 20%,每月省下 1,500 多个工程小时。这两个都是厂商案例,没有说明测量方法。
Google 的证据更像学术研究。它的工程师做过一次有 96 名全职工程师参加的随机对照试验,AI 功能让任务用时缩短约 21%,但论文作者自己也说,置信区间很大。Google Research 报告,代码里由 AI 补全的字符已经和手敲的一样多;在一次 ID 类型迁移中,落地的改动有 80% 是 AI 写的,参与的工程师估计总耗时减少了一半。至于 Pichai 的说法,2024 年 10 月是 Google 超过四分之一的新代码由 AI 生成,到 2026 年 4 月是75%。这个比例的分母到底是字符、行数还是提交数,Google 没有交代,我只当它是个方向。
也不全是好消息。OpenAI 的 Codex 指南里有一句提醒:AI 代码审查不一定能让 PR 流程变快。写得快了,审得慢了,整体未必就快。
客服工单:自动化走得最远
客服工单量大、格式相近、对错容易判断,是最适合交给 AI 的活儿之一。Klarna 的案例经常被引用,但要注意 OpenAI 页面上写的只是上线第一个月的数据:客户解决问题的时间从 11 分钟降到 2 分钟以内。Intercom 的语音客服 Fin Voice,据 OpenAI 的企业报告,平均能端到端解决 53% 的来电。Anthropic 的案例里,使用自建智能体的 Zendesk 客户,自动解决率最多提高 10%,人工处理时间最多减少 80%。Carvana 则让 Claude 去修告警的根因,一个频道的告警因此减少了 56%。
xAI 公布了自家客服团队的情况:合并之后,工单量涨了 175%,却没有新招一个人;另一篇文章写到,一次事故中,智能体约 10 分钟清完了 204 张工单,整批操作由一名客服工程师审批。这些都是 xAI 自己说自己,没有第三方核实。
文档、检索和分析:用量最大
文档类工作在用量里占比最高,但结果很难自动打分,所以案例里的数字都要多留个心眼。据 OpenAI 的指南,Morgan Stanley 的顾问能查到的文档从 20% 升到了 80%。Spellbook 用 Claude 审合同,据 Anthropic 的案例,一份协议的完成时间从律师约 10 小时缩短到约 1 小时。BBVA 墨西哥的法务聊天机器人,据 OpenAI 的企业报告,每年自动处理 9,000 多次查询,相当于腾出 3 名全职员工。
Anthropic 自己的调研智能体是个有意思的例子:让多个子智能体并行检索,复杂问题的调研时间最多缩短 90%,代价是 token 用量约为普通对话的 15 倍。快是快了,是要花钱的。
后台流程:从对话走向自动执行
Anthropic 2026 年 1 月的报告说,企业越来越多地用 Claude 自动处理后台流程,比如邮件管理。这一类活儿牵涉钱,所以案例里普遍把“执行”和“审批”分开。Qonto 的智能体把开票时间缩短到原来的三分之一,每张发票都要客户确认后才发出。xAI 的采购智能体找出了超过 10 万美元的直接节省,其中一个产品有 43 个付费席位 90 天没人用过;但花钱、接受条款、给供应商发东西,都必须由人明确批准。
照着做,大概是这六步
把各家的工程文章和企业指南放在一起读,建议其实高度重合,大致可以排成六步。
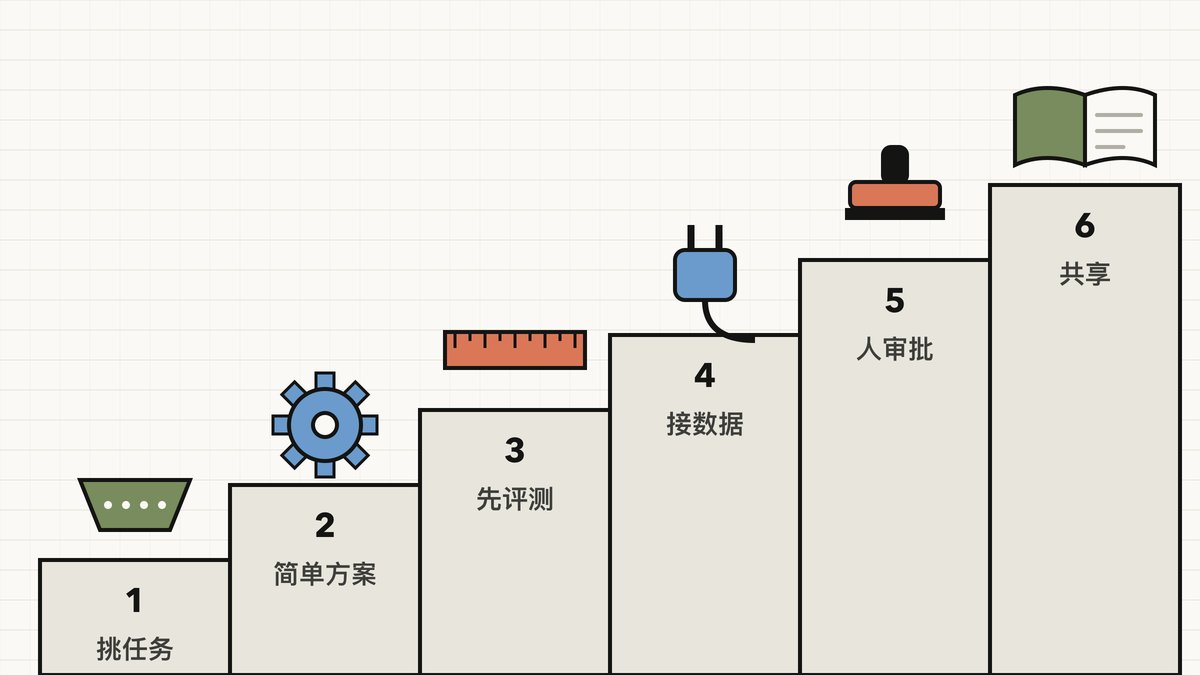
第一步,挑对任务
OpenAI 的用例指南建议,先从三类工作里找机会:重复的低价值任务、技能瓶颈,以及需要在模糊中做判断的问题。指南分析了 600 多个客户用例,发现大多可以归入六类基本用例:内容创作、自动化、研究、构思与策略、编码和数据分析。挑的时候按影响和投入打分,先做影响大、投入小的,并且每个季度重新打一次分,因为模型变强以后,原先难做的用例可能变容易。指南还建议让熟练的员工把工作流拆成一个个具体任务。
挑任务要看整条流程,不能只盯一个环节。Anthropic 指出,AI 帮不上太多忙的环节,可能变成新的瓶颈。OpenAI 的智能体指南也说得很实在:如果用例不满足那几个条件,普通的确定性程序可能就够了。
第二步,从最简单的做起
Anthropic 的《Building effective agents》建议先找最简单的方案,确有需要再增加复杂度,很多场景一次模型调用加检索就能解决。OpenAI 的智能体指南给了同样的建议:先把单个智能体的能力用足。真要上复杂的,Anthropic 把常见的工作流归成了五种模式:
| 模式 | 做法 | 适用场景 |
|---|---|---|
| 提示词链 | 把任务拆成固定的几步,每一步处理上一步的输出 | 任务能干净地拆成固定子任务 |
| 路由 | 先给输入分类,再交给专门的后续流程 | 输入分成明显不同的几类,而且分类准确 |
| 并行 | 子任务同时跑,或同一任务跑多遍再投票 | 子任务可以并行提速,或需要多个视角 |
| 编排者与执行者 | 一个模型动态拆分任务、分派下去,再汇总结果 | 事先无法预知需要哪些子任务 |
| 评估者与优化者 | 一个模型生成,另一个模型评价并反馈 | 评价标准清楚,迭代能带来可测的改进 |
Rocket Money 用的就是路由:据 Anthropic 的案例,它先用 Haiku 4.5 给请求分类,再分派给职责单一的子智能体。至于多智能体,前面说过 token 用量约为普通对话的 15 倍,我的看法是,只有任务价值高、又能并行的时候才值得上,后文会单独谈。
第三步,上线之前先建评测
OpenAI 的《AI in the Enterprise》总结了七条经验,第一条就是用系统的评测流程,衡量模型在自己用例上的表现。Morgan Stanley 是个典型:每个 AI 用例上线前都先跑评测,上线后还每天用一组示例问题跑回归测试。
评测集不必一开始就很大。Anthropic 的评测文章说,20 到 50 个取自真实失败的简单任务就够起步;它自己做多智能体系统时,起步也只用了约 20 个贴近真实用法的查询。回归评测的通过率应接近 100%,能力评测则用来衡量智能体还做不稳的事。评测还有个附带的好处,就是换模型变快:按 Anthropic 的说法,没有评测的团队要花几周测试新模型,有评测的团队很快就能下判断。OpenAI 也建议先用最强的模型做原型,定下性能基线,再换小模型省钱,Indeed 就这样微调了一个小模型,少用 60% 的 token,结果差不多。
对写代码来说,评测就是测试。OpenAI 的 Codex 指南说,先写好测试,往往是让智能体开发功能的第一步;Claude Code 的文档也建议给 Claude 一个能自己运行的检查,比如测试、构建或截图对比。
第四步,把数据和工具接上
Anthropic 推测,复杂任务更受制于能不能拿到信息,模型能力反而在其次。OpenAI 的企业报告说得更直白:主要约束不再是模型性能或工具,而是组织有没有准备好。它的数据也能佐证:企业版月活用户里,19% 从没用过数据分析,14% 从没用过推理,12% 从没用过搜索。接的时候有三件事要注意。上下文要精简,Anthropic 说它是边际收益递减的有限资源。工具要少而精,Anthropic 建议先做几个针对高价值工作流的工具,别把每个 API 都包一层;它做 SWE-bench 智能体时,花在工具上的时间比花在提示词上的还多。权限则要先定好,OpenAI 建议管理者给智能体接上完成工作所需的上下文和工具,同时定清权限、审核和治理规则。
第五步,高风险的操作留给人,再逐步放权
OpenAI 的智能体指南写道,敏感、不可逆或高风险的操作应当触发人工监督,直到团队对智能体的可靠性有了信心。
xAI 在自己公司部署 Grok Bot 时,走的也是这条路,只不过材料出自它自己的三篇文章,和 OpenAI 的指南是两回事。《Grok Bot for Enterprise》说,Grok Bot 默认没有任何权限,只能进入用户替它登录的账户。客服那篇说,一开始只让它写内部备注,每个写操作都要人工批准,第一天人工复核之后,才让它直接回复客户。采购那篇则是前面提过的,花钱和对外发送都要人明确批准。
放权的节奏可以跟着智能体的表现走。Anthropic 统计,Claude Code 在需要人介入之前,能连续执行的操作从约 10 个增加到约 20 个。OpenAI 的 Codex 指南把分工写得很直白:智能体负责第一遍实现,工程师负责审阅、修改和把握方向。
第六步,把个人的用法变成团队的做法
OpenAI 的企业报告说,约 20% 的企业版消息是通过 Custom GPT 或 Project 处理的,BBVA 的员工五个月里建了 2,900 多个 Custom GPT。员工上手也需要时间:Anthropic 发现,用了 Claude 六个月以上的用户,对话成功率要高 10%。OpenAI 总结领先企业的做法是衡量使用深度、为生产环境建立治理、投入培训、推广行之有效的做法,并逐步把工作从对话式辅助转为交给智能体去做。
效果怎么量,才不会被数字骗
各家报告里的数字,大致分三种,能说明的事情各不相同。
| 数据类型 | 例子 | 能说明什么 | 说明不了什么 |
|---|---|---|---|
| 用量数据 | 消息数、token 数、席位数 | 员工在用,用得有多深 | 业务价值 |
| 自报数据 | 问卷里“每天省了多少分钟” | 员工的感受 | 实际省下的时间 |
| 实测数据 | 合并 PR 数、处理时长、随机对照试验 | 指标的真实变化 | 换个团队能否复现 |
用量数据最容易被误读。OpenAI 自己就承认,token 并不能直接衡量业务价值。它说前沿企业每个活跃用户的输出 token 是普通企业的 8.3 倍,但这里的“前沿”和它 2025 年 12 月报告里的“前沿员工”并不是一个意思,后者指的是处于第 95 百分位的员工,几份报告里的倍数不能直接放在一起比。
自报数据则要看是谁在报。OpenAI 调查了近 100 家企业的 9,000 名员工,受访者自报每个活跃日能省 40 到 60 分钟;Google 称 Workspace 用户每周平均省下 105 分钟,依据是 3,200 多份员工问卷;Anthropic 的问卷里,86%、82% 和 69% 的受访者说工作速度、范围和质量提高了,不过 Anthropic 也承认这份问卷不能代表总体人群。这些都是员工的感受,不是计时器量出来的。
还有一类是让模型自己估。Anthropic 让 Claude 估算对话中任务的用时:没有 AI 时平均要 90 分钟,有了 Claude 能缩短约 80%。但这个估算没有算上对话之外花的时间,包括核对 Claude 的工作质量和准确性。
回到 GDPval
文章开头那个 90 倍和 1.39 倍,现在可以展开说了。GDPval 完整版有 1,320 个专业任务,专家完成一个任务平均要 7 小时。首批结果里表现最好的是 Claude Opus 4.1,47.6% 的交付物被评为不输专家。至于“快 100 倍”,论文的表 2 给出了把审核和返工算进去之后的样子:
| 模型 | 只算推理 | 审核一次,不合格就自己做 | 反复让模型重做,最后自己兜底 |
|---|---|---|---|
| GPT-5 | 快 90 倍 | 快 1.12 倍 | 快 1.39 倍 |
| GPT-4o | 快 327 倍 | 0.87 倍(反而更慢) | 0.46 倍(反而更慢) |
数字取自论文第 15 页的表 2,论文自己也写道,算上审核和返工,用模型的收益会缩水。更值得管理者留意的是失败的代价:GPT-5 输给专家的那些评分里,约 29% 被评为“差”或“灾难性”。2025 年 12 月,OpenAI 又说 GPT-5.2 在 70.9% 的比较中胜过或打平专家,读这个数字时,同样要对照论文里的审核场景。
Anthropic 的估算也有类似的水分。按任务成功率调整之后,隐含的生产率提升大约减半,从每年 1.8 个百分点降到约 1.0 个百分点;估计的任务成功率,Claude.ai 上是 67%,API 上只有 49%。
我自己会这样设计度量
下面这几条是我根据上面的材料整理的,不是哪一家实验室的原话。上线之前先把基线测下来,记下任务现在的用时、错误率和返工次数,否则上线之后的数字没有参照。用时要把审核和返工都算进去,GDPval 的表 2 已经说明,漏掉审核时间,收益会被放大几十倍。能做对照就做对照:Google 那次随机对照试验只有 96 人,作者仍然提醒置信区间很大,Google Research 也把在线 A/B 实验视为上线 AI 功能的关键。失败要记录得有多严重,因为平均分会掩盖少数灾难性错误。最后,自报、用量和实测要分开报,混在一张表里,管理层很容易把感受当成结果。
让智能体分工、连续干几个小时之前,我会先算几笔账
前面六步默认的场景,是一个智能体花几分钟做完一件事。这一年 Anthropic 和 OpenAI 谈得更多的,是另外两种用法:让几个智能体分头干活,以及让一个智能体无人值守地连续干上几个小时。OpenAI 说,在内部评测里观察到 GPT-5.1-Codex-Max 连续做一个任务超过 24 小时;Anthropic 说,观察到 Claude Sonnet 4.5 在复杂的多步任务上保持专注 30 多个小时。这两个数字都是厂商在自己的测试里看到的上限。
日常用法要短得多。Anthropic 统计了 Claude Code 的真实会话,每一轮工作的中位数只有 45 秒左右;最长的那 0.1% 的轮次在三个月里从不到 25 分钟涨到了 45 分钟以上,2026 年 1 月中旬以后又有所回落。OpenAI 用模型估算用户交给 Codex 的活儿相当于人干多久,到 2026 年 5 月,抽样用户里有 70.2% 至少交过一件需要人干一小时以上的活。OpenAI 也提醒,这些时长门槛是模型估出来的,只能看方向,不能当精确值。上限和日常差得这么远,我觉得管理者先要回答三件事:手上哪些活值得这样跑,跑的时候人怎么盯着,跑完这笔账怎么算。
多智能体和长时间运行常常一起出现,解决的问题却不一样。多智能体解决的是一件事能拆成几块、需要并行或者需要不同的工具和权限;长时间运行解决的是一件事太大,一个上下文窗口装不下。下面分开说。
多个智能体只在活儿拆得开的时候才划算
第二步引用过 Anthropic 的调研系统,多智能体的 token 用量约为普通对话的 15 倍。同一篇文章也交代了多花的钱换来了什么:在内部的调研评测上,Opus 4 带几个 Sonnet 4 子智能体的组合,比单个 Opus 4 高出 90.2%;在 BrowseComp 评测里,光是 token 用量一项就解释了 80% 的成绩差异。Anthropic 自己的解释是,多智能体之所以有效,主要是帮系统花够解决问题所需的 token。文章也写明了不合适的情况:所有智能体必须共享同一份上下文,或者智能体之间依赖很多的任务,今天还不适合用多智能体。
Claude Code 的文档把这条线画得更具体。agent teams 目前还是实验功能,文档说它会带来协调开销,token 用量明显多于单个会话;顺序执行的任务、要改同一个文件的任务、依赖很多的任务,用单个会话或子智能体更合适。真要组队,文档建议多数情况先用 3 到 5 个队友。子智能体的用处朴素得多:把检索和探索的输出挡在主对话之外,还可以把这类活交给 Haiku 这样更快、更便宜的模型。
OpenAI 的说法几乎一样。Agents SDK 的编排指南建议,能用一个智能体就只用一个,因为拆得太早只会多出提示词、追踪记录和审批环节,工作流未必更好。它的智能体指南给了拆分的信号:智能体跟不上复杂的指令,或者总是选错工具。工具的数量倒在其次,指南说有的系统能管好 15 个以上界限清楚的工具,有的系统 10 个相互重叠的工具就出错。决定拆了,还要先定谁负责最后交给用户的答复:经理智能体把专门的智能体当工具调用、自己汇总,还是把对话整个交接给专门的智能体。
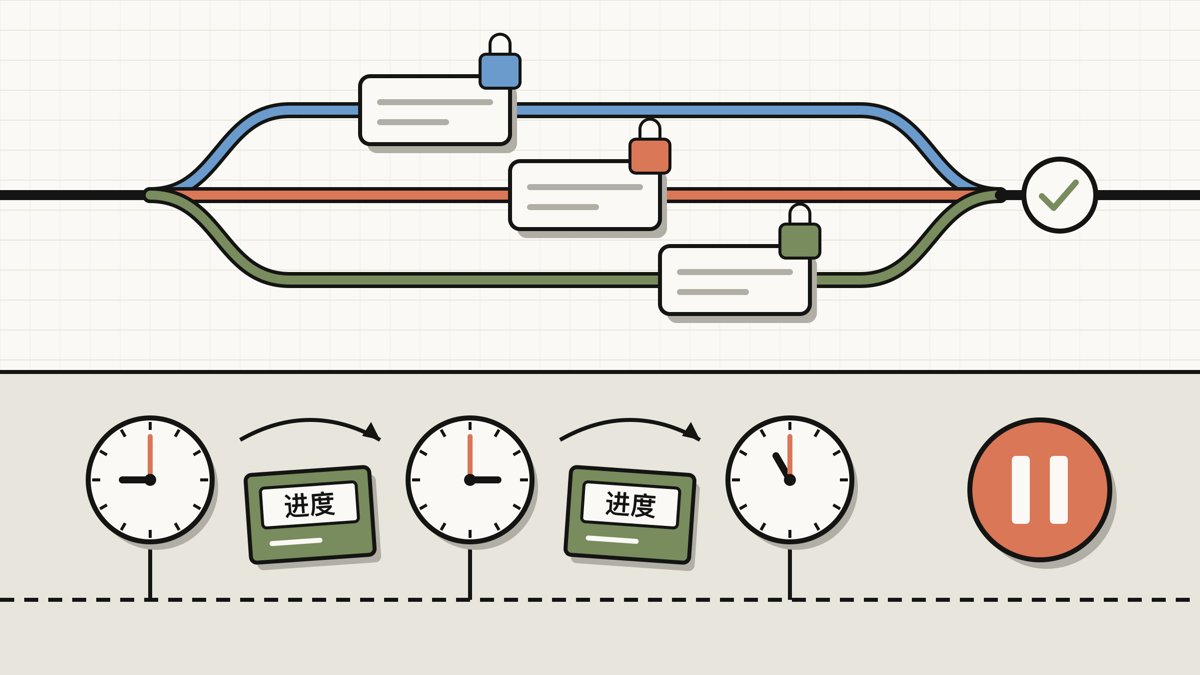
把一组智能体放出去长时间跑,公开材料里最完整的例子是 Anthropic 研究员 Carlini 写 C 编译器的实验。他让 16 个 Claude 并行写一个 Rust 版的 C 编译器,前后近 2,000 个 Claude Code 会话,API 费用约 2 万美元,最后得到一个能编译 Linux 6.9 内核的十万行编译器。这个实验对管理者最有用的,是它卡住的地方。测试集里有几百个互相独立的失败用例时,每个智能体挑一个去修,并行毫不费力;到了编译 Linux 内核这一整件事上,每个智能体都撞上同一个 bug,修完又互相覆盖对方的改动。Carlini 的解法是拿 GCC 当参照:随机让 GCC 编译大部分文件,只把剩下的文件交给新编译器,这样一件大事又被拆成了可以分头查的小事。他还写道,用来判断对错的验证器必须接近完美,否则 Claude 会去解决一个错的问题。
所以我判断要不要上多智能体,会问三个问题:活儿能不能拆成几块,每一块有没有自己的通过标准;任务的价值够不够付几倍到十几倍的 token;几块之间要不要频繁对齐。有一个问题答不上来,就先用一个智能体,最多再配几个只读的子智能体去做检索。
智能体连续干几个小时,靠的是写在外面的记录
长时间运行的第一道坎是上下文窗口有限。Anthropic 的《Effective harnesses for long-running agents》把智能体比作轮班的工程师:每个新会话开始时,都不记得前一个会话做过什么。即使开着上下文压缩,只给一句“做一个 claude.ai 的克隆”这样的高层提示词,Opus 4.5 也做不出能上生产的网页应用。失败有两种:智能体想一口气做完太多,做到一半上下文用完,留下没写说明的半成品;或者后来的会话看到已经有了进展,就宣布完工。
Anthropic 的解法很像管一支轮班的工程团队。第一个会话只做准备:把需求展开成一份功能清单,claude.ai 克隆的例子里有 200 多项功能,全部先标成“未通过”;再写一个启动脚本、一个进度文件,做第一次 git 提交。之后每个会话开工先读 git 日志和进度文件,跑一遍基本测试,然后只做一项功能,测完提交,更新进度。OpenAI 的开发者博客记录过一次让 GPT-5.3-Codex 不间断跑了约 25 小时、用了约 1,300 万 token、写了约 3 万行代码的实验,作者说最重要的技巧是持久的项目记忆:把规格、计划、约束和状态写进 Markdown 文件,让 Codex 反复回看。作者也说明,这只是一次实验,不是生产部署。
OpenAI 的另一篇工程文章把同样的思路用在了一整个产品上。一个团队五个月里没有手写一行代码,最初三名工程师驱动 Codex,合并了约 1,500 个 PR;单次 Codex 运行常常在一个任务上连续跑六个小时以上,往往是在人睡觉的时候。这个团队试过一份大而全的 AGENTS.md,失败了,改成给 Codex 一张地图,而不是一本一千页的手册:AGENTS.md 只留约 100 行,当作目录,知识放进仓库的 docs/ 目录,复杂任务写成带进度和决策日志的执行计划。他们的理由是,智能体运行时在上下文里看不到的东西,对它来说就不存在。放到企业里,Slack 里定下的约定、老员工脑子里的规矩,不写进智能体读得到的地方,智能体就不知道。
平台也在补这一块。Anthropic 推出了上下文编辑和记忆工具,按它在内部智能体检索评测上的测试,两者合用比基线高 39%,在一个 100 轮的网页检索评测里还把 token 消耗降低了 84%。OpenAI 的 Responses API 有后台模式,让长任务不用担心超时和断线;GPT-5.1-Codex-Max 是 OpenAI 第一个经过训练、能借助压缩跨多个上下文窗口工作的模型。托管服务连会话的保存和恢复也接了过去:Anthropic 的 Managed Agents 把会话日志放在 harness 之外,所以 harness 崩溃时不需要保住任何东西,新起一个就能从最后一条事件接着跑;OpenAI 2026 年 9 月发布的 Agents API,则由 OpenAI 管理会话、编排、上下文压缩和恢复。
检查点要分清各管什么。Claude Code 会自动记录 Claude 改过的文件,可以回退,但文档写明Bash 命令改动的文件不在检查点里,长期的版本历史还是要交给 Git 这样的版本控制。Anthropic 的调研系统出了错也不从头再来,而是从出错时智能体所在的位置接着跑。我的做法是:智能体的成果一律进 Git 或者同类的版本库,进度写进文件,平台自带的压缩和检查点当作补充。
还有一点容易被忽视,这些外部结构会过时。Anthropic 发现 Sonnet 4.5 快到上下文上限时会提前收尾,于是在 harness 里加了上下文重置;换成 Opus 4.5 以后,这个毛病没了,重置成了累赘。另一篇工程文章说得更一般:harness 里的每个组件,都对应一个“模型自己做不到什么”的假设。第一步说过用例要每个季度重新打分,harness 也一样,每换一次模型,都值得拿评测重测一遍,看哪些组件还在起作用。
无人值守的时候,人要站在能叫停的位置上
第五步说,高风险的操作留给人批准。智能体一跑几个小时,逐条批准就不现实了。Anthropic 统计 Claude Code 用户:新用户约 20% 的会话开着全自动批准,用得久的用户超过 40%;可用得久的用户中途打断得反而更多,打断的轮次从 5% 升到约 9%。Anthropic 的解读是,监督方式从逐条批准变成了盯着看、出问题再插手。逐条批准本身也有毛病:在 Claude Code 里,用户实际上会通过 93% 的权限请求,点多了就不再细看。所以 Anthropic 的建议是,与其规定每个动作都要人批准,不如看人是否处在能有效监控和介入的位置上。
智能体自己停下来问,也是一种监督。在最复杂的任务上,Claude Code 主动停下来澄清的次数是人打断次数的两倍多。Anthropic 后来做了 auto mode,用分类器代替人批准大部分动作,但它自己公布的一个数字值得管理者记住:对真实发生过的越权动作,分类器有 17% 没拦住。分类器能减轻批准疲劳,不可逆的操作仍然要靠权限本身拦住。
OpenAI 的做法是先限制智能体的运行环境。Codex 默认在沙箱里运行,网络是关着的,除非开发者自己打开,OpenAI 也建议保持这种受限模式。它还提醒,技能加上不受限的网络,就是一条高风险的数据外泄通道。审查放在哪里,它也写得清楚:Codex 能跑的任务越长,部署之前由开发者审查智能体的工作就越重要,Codex 做的代码审查只能算多一个审查者,不能替代人的审查。
前面那个不手写代码的 OpenAI 团队走得更远:人可以审 PR,但不是必须,合并前的阻塞检查也很少。这一点我不建议照搬。文章自己说,这种做法放在吞吐量低的环境里是不负责任的,而且依赖这个仓库特有的工具和结构,不能假设换个地方也成立。写 C 编译器的 Carlini 也说,在自主运行的系统里,很容易看到测试通过就以为活干完了,实际上很少如此。
长时间运行的成本、成功率和返工要分开记账
钱最先要算。Anthropic 做过一次对照:同一句提示词,单个智能体跑 20 分钟、花 9 美元,规划、生成、评估三个智能体组成的完整 harness 跑 6 小时、花 200 美元,贵了 20 多倍,不过只有后者做出的游戏真能玩。换上更强的模型、精简 harness 之后,做一个浏览器里的音乐制作软件,仍然花了约 4 小时和 124 美元。作者的结论是,评估智能体只在任务超出当前模型单独能稳定完成的范围时才值这个钱。这次对照的做法本身就值得学:同一批任务,单智能体和多智能体各跑一遍,把花费和结果摆在一起比。
成功率要看是谁判定的。Anthropic 内部的统计说,Claude Code 在最难任务上的成功率翻了一番,同时每个会话里人介入的平均次数从 5.4 降到 3.3,但任务难度和成败都是让 Claude 分类判定的。智能体给自己的作品打分尤其靠不住:Anthropic 发现,让智能体评价自己做的东西,它们往往信心十足地夸奖;单独的评估智能体一开始也会发现真问题,然后说服自己问题不大,照样放行,作者反复改了几轮提示词才可用。
返工最容易漏记。OpenAI 那个团队一度每个周五,也就是一周的 20%,都花在清理“AI slop”上,后来改成让后台的 Codex 任务定期扫描,再开重构 PR。这部分时间不记进账里,长时间运行的收益就会被高估。
落到台账上,我会给每个长时间运行的任务记五样东西:总 token 费用,墙钟时间,人介入了几次、每次多久,第一次交付能不能通过一个不是智能体自己写的检查,以及之后一个月里为这个任务返工花了多少人时。再拿同样的任务让单个智能体跑一遍,当作基线。这几样数字放在一起,比“它连续跑了 24 小时”更能说明问题。
Google 转述的客户数字
Google DeepMind 公开的成果,大多发生在 Google 自家的基础设施上。DeepMind 称,AlphaEvolve 找到的一种调度方法平均为 Google 收回了全球 0.7% 的算力;2016 年,它称机器学习把一座数据中心的制冷能耗最多降低了 40%,相当于 PUE 开销降低 15%。
客户数字就没这么好验证了。Google Cloud 维护着一份客户用例清单,目前列了 1,302 个用例,数字大多只有一句话,不说明怎么测的。我抽查了其中四条:
| 客户 | Google 称 | 我找到的佐证 | 本文的处理 |
|---|---|---|---|
| Macquarie Bank | 省下超过 10 万小时 | iTnews 报道,Macquarie 的高管在 Google Cloud Next 大会上说已经省下 13 万小时 | 有佐证,但数字不同,而且是在厂商大会上说的 |
| Virgin Voyages | 部署了 1,000 多个智能体,活动制作时间减少 40% | Virgin Voyages 自己的新闻稿说内容制作时间平均减少 60% | 有客户本人的佐证,数字不同 |
| CME Group | 多数开发者自报每月至少省 10.5 小时 | 没找到 | 只写作“Google 称” |
| Deloitte | 分析师效率提高 60% 以上 | 没找到 | 只写作“Google 称” |
Google Cloud 的高管问卷也要仔细读。Google 称,在报告生产率有提升的高管中,39% 说生产率至少翻了一番。注意分母只是“已经报告有提升”的那部分人,不是全部受访者。
neo lab 的数字,大多站不住
我按前面的标准查了 15 家 neo lab:Mistral AI、Cohere、Thinking Machines Lab、Sakana AI、智谱、MiniMax、DeepSeek、月之暗面、Safe Superintelligence、Reflection AI、Poolside、Magic、AI21、Aleph Alpha 和 AMI Labs。阶跃星辰和零一万物的官网抓取不到,这次没有覆盖。
结果有点出乎意料:没有哪一家的员工提效数字,同时经过客户确认和独立核实。符合收录标准的,只有下面这些,而且每一条都有保留:
| 实验室 | 说法 | 证据 | 本文的判断 |
|---|---|---|---|
| DeepSeek | 深圳福田区称,基于 DeepSeek 的 AI“数智员工”让公文审核时间缩短 90% | 客户(区政府)自己发布 | 成立,但原文没有基线和测量方法 |
| Thinking Machines Lab | Glean 称,用 Tinker 训练的 Waldo 模型带来约 50% 的延迟下降和约 25% 的 token 节省,质量没有下降 | 客户自己发布 | 成立,但衡量的是系统效率,不是员工效率 |
| Thinking Machines Lab | Bridgewater 的研究人员称,微调后的模型让每个任务的推理成本降到约十四分之一 | 客户署名,但文章发在 Thinking Machines 的网站上 | 部分成立 |
| 智谱 | 招股章程称,为一家金融集团定制的模型在新规问答上的AI 自动化率超过 50% | 港交所招股章程 | 成立,但客户匿名,“自动化率”也没有定义 |
| 智谱 | 2026 年中期公告称,网络安全方向的试点进展最快,法律、金融、教育等方向的试点尚未带来实质收入 | 港交所公告 | 成立,是一条反面证据 |
| MiniMax | 开放平台和企业服务收入增长 703.1% | 港交所公告 | 只说明需求在增长,不说明效率提升 |
| Mistral AI | CMA CGM 称,基于 Mistral 的平台面向近 8 万名员工;路透社 2025 年报道的则是 CMA CGM 的预期 | 客户自己发布,媒体报道 | 只说明部署规模,没有效果数字 |
福田区那个 90% 要配一条提醒。JMIR 上一篇同行评审的综述,统计了中国医院部署 DeepSeek 的公开信息,发现只有 22% 的部署给出了评估结果,而且医院往往报告更高的性能、更少的风险。机构自己公布的“提效”,要打个折扣来看。
更多的说法,只在 neo lab 自家的网站上出现,我没有采信,列在下面:
| 实验室 | 自述的说法 | 剔除原因 |
|---|---|---|
| Mistral AI | Cisco 制作续约方案的时间最多减少 20% | 原文注明是“估计”,没找到 Cisco 自己的来源 |
| Mistral AI | SAP 为瑞士联邦铁路(SBB)做的客服机器人减少约 80% 的重复咨询 | 原文注明是“估计”,没找到 SAP 或 SBB 的来源 |
| Mistral AI | 欧洲专利局的识别系统每天转写 40 万页 | 欧洲专利局的新闻稿只确认了部署,没给数字 |
| Mistral AI | Capgemini 开发者的采用率从 30% 升到 100% | 只出现在 Mistral 的网站上 |
| Cohere | CoreWeave 的工单处理时间从 4–8 天降到 2–5 天 | 原文把改进同时归功于内部流程,效果没有单独测出 |
| Sakana AI | 三井住友银行的提案书制作预计从一两周缩短到几十分钟至几小时 | 原文写的是“预计” |
| Sakana AI | 三菱 UFJ 银行的验证确认融资流程效率有所提升 | 没有数字 |
| Thinking Machines Lab | Chroma 的检索智能体推理速度最多快 10 倍 | 没找到 Chroma 自己的来源 |
| Aleph Alpha | 一家全球芯片厂商的检索时间缩短 90% | 客户没有具名 |
另有几家,官网上根本没有企业提效的内容。Safe Superintelligence 说公司只有一个目标、一个产品:安全的超级智能;DeepSeek、Reflection AI、Poolside、Magic 和 AMI Labs 的官网和新闻页,我也都翻过,没有企业提效的案例或数字。
总的来看,neo lab 公开的多是部署规模和采用情况,客户也常常出面确认部署,但由客户本人确认、又经过实测的提效数字,我只找到上表那几条。
如果让我带第一个项目
综合上面这些,我会这样开头:先挑一条具体的工作流,而不是先挑一个工具,把每一步写下来,标出哪些步骤重复、哪些结果容易验证。接着把基线测下来,每件任务现在的用时、错误率和返工次数都记上。第一版做得越简单越好,一次模型调用加检索能解决的,就不要上智能体。上线前先写 20 到 50 条评测,题目取自真实的失败案例,以后每次改提示词或换模型都重跑。数据和工具只接必要的,给智能体最小的权限,并记录每一次调用。花钱、对外发送、不可逆的操作,一律留给人批准,智能体先只出草稿,再根据评测结果逐步放权。最后汇报效果时,用时要包括审核和返工,用量、自报和实测三类数字分开报;有效的做法做成团队共享的模板,每个季度把用例重新打一遍分,把变得容易的往前排。等单个智能体在评测上稳定了,再考虑让几个智能体分工,或者让一个智能体连续跑几个小时;动手之前,先把功能清单、进度文件和版本库准备好,台账里给返工单独留一栏。
参考来源
所有链接都在 2026-10-20 读取;“fetched”后的日期链接到 Internet Archive 的存档。厂商客户案例里的数字都由厂商或客户自报,原文大多没有说明测量方法。
- Anthropic — Anthropic Economic Index report: Cadences(2026-06-26) — fetched 2026-10-20
- Anthropic — Anthropic Economic Index report: Cadences,问卷部分(约 9,700 名受访者) — fetched 2026-10-20
- Anthropic — Anthropic Economic Index report: Cadences,问卷的局限 — fetched 2026-10-20
- Anthropic — Anthropic Economic Index report: Uneven geographic and enterprise AI adoption(2025-09-15) — fetched 2026-10-20
- Anthropic — Anthropic Economic Index report(2025-09-15),关于上下文瓶颈的段落 — fetched 2026-10-20
- Anthropic — Anthropic Economic Index report: Economic primitives(2026-01-15) — fetched 2026-10-20
- Anthropic — Anthropic Economic Index report: Economic primitives,任务成功率 — fetched 2026-10-20
- Anthropic — Anthropic Economic Index report: Economic primitives,后台流程 — fetched 2026-10-20
- Anthropic — Anthropic Economic Index report: Learning curves(2026-03-24) — fetched 2026-10-20
- Anthropic — Agentic coding and persistent returns to expertise(2026-06-16) — fetched 2026-10-20
- Anthropic — Anthropic Economic Index: AI’s impact on software development(2025-04-28) — fetched 2026-10-20
- Anthropic — Estimating AI productivity gains from Claude conversations(2025-11-25) — fetched 2026-10-20
- Anthropic — Estimating AI productivity gains,估算没有计入的时间 — fetched 2026-10-20
- Anthropic — Estimating AI productivity gains,关于瓶颈的段落 — fetched 2026-10-20
- Anthropic — How AI is transforming work at Anthropic(2025-12-02),调查方法 — fetched 2026-10-20
- Anthropic — How AI is transforming work at Anthropic,自报数字 — fetched 2026-10-20
- Anthropic — How AI is transforming work at Anthropic,合并 PR 数据 — fetched 2026-10-20
- Anthropic — How AI is transforming work at Anthropic,新增工作 — fetched 2026-10-20
- Anthropic — How AI is transforming work at Anthropic,委派习惯 — fetched 2026-10-20
- Anthropic — How AI is transforming work at Anthropic,连续动作数 — fetched 2026-10-20
- Anthropic — Building effective agents(2024-12-19;现行页面已注明部分工具有变化) — fetched 2026-10-20
- Anthropic — Building effective agents,提示词链 — fetched 2026-10-20
- Anthropic — Building effective agents,路由 — fetched 2026-10-20
- Anthropic — Building effective agents,并行 — fetched 2026-10-20
- Anthropic — Building effective agents,编排者和执行者 — fetched 2026-10-20
- Anthropic — Building effective agents,评估者和优化者 — fetched 2026-10-20
- Anthropic — Building effective agents,附录:工具设计 — fetched 2026-10-20
- Anthropic — How we built our multi-agent research system(2025-06-13),token 用量 — fetched 2026-10-20
- Anthropic — How we built our multi-agent research system,并行带来的提速 — fetched 2026-10-20
- Anthropic — How we built our multi-agent research system,评测起步 — fetched 2026-10-20
- Anthropic — Effective context engineering for AI agents(2025-09-29) — fetched 2026-10-20
- Anthropic — Writing effective tools for agents — with agents(2025-09-11) — fetched 2026-10-20
- Anthropic — Demystifying evals for AI agents(2026-01-09) — fetched 2026-10-20
- Anthropic — Demystifying evals for AI agents,回归评测 — fetched 2026-10-20
- Anthropic — Demystifying evals for AI agents,换模型的速度 — fetched 2026-10-20
- Anthropic — Claude Code 文档:Best practices(页面未标日期;原 anthropic.com 工程博客文章已跳转到这里) — fetched 2026-10-20
- Anthropic — 客户案例:Stripe(页面未标日期) — fetched 2026-10-20
- Anthropic — 客户案例:Zendesk(页面未标日期) — fetched 2026-10-20
- Anthropic — 客户案例:Carvana(页面未标日期) — fetched 2026-10-20
- Anthropic — 客户案例:Qonto(页面未标日期) — fetched 2026-10-20
- Anthropic — 客户案例:Spellbook(页面未标日期) — fetched 2026-10-20
- Anthropic — 客户案例:Rocket Money(页面未标日期) — fetched 2026-10-20
- Anthropic — Introducing Claude Sonnet 4.5(2025-09-29),保持专注的时长 — fetched 2026-10-20
- Anthropic — Measuring AI agent autonomy in practice(2026-02-18),每轮时长中位数 — fetched 2026-10-20
- Anthropic — Measuring AI agent autonomy in practice(2026-02-18),第 99.9 百分位的每轮时长 — fetched 2026-10-20
- Anthropic — Measuring AI agent autonomy in practice(2026-02-18),1 月中旬以后的回落 — fetched 2026-10-20
- Anthropic — Measuring AI agent autonomy in practice(2026-02-18),全自动批准的比例 — fetched 2026-10-20
- Anthropic — Measuring AI agent autonomy in practice(2026-02-18),打断率 — fetched 2026-10-20
- Anthropic — Measuring AI agent autonomy in practice(2026-02-18),智能体主动停下 — fetched 2026-10-20
- Anthropic — Measuring AI agent autonomy in practice(2026-02-18),对监督方式的建议 — fetched 2026-10-20
- Anthropic — Measuring AI agent autonomy in practice(2026-02-18),内部成功率与人工介入次数 — fetched 2026-10-20
- Anthropic — Measuring AI agent autonomy in practice(2026-02-18),脚注 7,成功率由 Claude 判定 — fetched 2026-10-20
- Anthropic — How we built our multi-agent research system(2025-06-13),多智能体与单智能体的对比 — fetched 2026-10-20
- Anthropic — How we built our multi-agent research system(2025-06-13),token 用量解释成绩差异 — fetched 2026-10-20
- Anthropic — How we built our multi-agent research system(2025-06-13),多智能体为什么有效 — fetched 2026-10-20
- Anthropic — How we built our multi-agent research system(2025-06-13),不适合多智能体的任务 — fetched 2026-10-20
- Anthropic — How we built our multi-agent research system(2025-06-13),出错后续跑 — fetched 2026-10-20
- Anthropic — Claude Code 文档:Orchestrate teams of Claude Code sessions(页面未标日期),token 开销 — fetched 2026-10-20
- Anthropic — Claude Code 文档:Orchestrate teams of Claude Code sessions(页面未标日期),适用场景 — fetched 2026-10-20
- Anthropic — Claude Code 文档:Orchestrate teams of Claude Code sessions(页面未标日期),队伍规模 — fetched 2026-10-20
- Anthropic — Claude Code 文档:Create custom subagents(页面未标日期),用便宜模型控制成本 — fetched 2026-10-20
- Anthropic — Claude Code 文档:Checkpointing(页面未标日期),Bash 改动不在检查点里 — fetched 2026-10-20
- Anthropic — Claude Code 文档:Checkpointing(页面未标日期),检查点与版本控制 — fetched 2026-10-20
- Anthropic — Building a C compiler with a team of parallel Claudes(2026-02-05),会话数与费用 — fetched 2026-10-20
- Anthropic — Building a C compiler with a team of parallel Claudes(2026-02-05),编译内核时并行失效 — fetched 2026-10-20
- Anthropic — Building a C compiler with a team of parallel Claudes(2026-02-05),验证器 — fetched 2026-10-20
- Anthropic — Building a C compiler with a team of parallel Claudes(2026-02-05),自主开发的风险 — fetched 2026-10-20
- Anthropic — Effective harnesses for long-running agents(2025-11-26),会话之间没有记忆 — fetched 2026-10-20
- Anthropic — Effective harnesses for long-running agents(2025-11-26),只有压缩还不够 — fetched 2026-10-20
- Anthropic — Effective harnesses for long-running agents(2025-11-26),第一种失败 — fetched 2026-10-20
- Anthropic — Effective harnesses for long-running agents(2025-11-26),第二种失败 — fetched 2026-10-20
- Anthropic — Effective harnesses for long-running agents(2025-11-26),功能清单 — fetched 2026-10-20
- Anthropic — Effective harnesses for long-running agents(2025-11-26),每个会话的开工步骤 — fetched 2026-10-20
- Anthropic — Harness design for long-running application development(2026-03-24),harness 组件对应的假设 — fetched 2026-10-20
- Anthropic — Harness design for long-running application development(2026-03-24),单智能体与完整 harness 的费用,表格:Solo 20 min $9,Full harness 6 hr $200 — fetched 2026-10-20
- Anthropic — Harness design for long-running application development(2026-03-24),DAW 一例的费用 — fetched 2026-10-20
- Anthropic — Harness design for long-running application development(2026-03-24),评估智能体何时值得 — fetched 2026-10-20
- Anthropic — Harness design for long-running application development(2026-03-24),自我评价 — fetched 2026-10-20
- Anthropic — Harness design for long-running application development(2026-03-24),评估智能体放水 — fetched 2026-10-20
- Anthropic — Managing context on the Claude Developer Platform(2025-09-29),记忆工具与上下文编辑 — fetched 2026-10-20
- Anthropic — Managing context on the Claude Developer Platform(2025-09-29),100 轮检索评测 — fetched 2026-10-20
- Anthropic — Scaling Managed Agents: Decoupling the brain from the hands(2026-04-08),harness 崩溃后的恢复 — fetched 2026-10-20
- Anthropic — Scaling Managed Agents: Decoupling the brain from the hands(2026-04-08),上下文重置成了累赘 — fetched 2026-10-20
- Anthropic — How we built Claude Code auto mode(2026-03-25),权限请求的通过率 — fetched 2026-10-20
- Anthropic — How we built Claude Code auto mode(2026-03-25),分类器的漏报率 — fetched 2026-10-20
- OpenAI — The state of enterprise AI: 2025 report(发布页日期 2025-12-08),方法说明,PDF 第 4 页,原文:“An OpenAI survey of 9,000 workers across almost 100 enterprises” — fetched 2026-10-20
- OpenAI — The state of enterprise AI: 2025 report(发布页日期 2025-12-08),自报省时,PDF 第 7 页,原文:“On average, ChatGPT Enterprise users attribute 40–60 minutes of time saved per active day to their use of AI” — fetched 2026-10-20
- OpenAI — The state of enterprise AI: 2025 report(发布页日期 2025-12-08),Custom GPT 和 Project,PDF 第 5 页,原文:“approximately 20% of all Enterprise messages were processed via a Custom GPT or Project.” — fetched 2026-10-20
- OpenAI — The state of enterprise AI: 2025 report(发布页日期 2025-12-08),前沿员工的定义,PDF 第 13 页,原文:“Frontier workers generate 6x more messages than the median worker.” — fetched 2026-10-20
- OpenAI — The state of enterprise AI: 2025 report(发布页日期 2025-12-08),未用功能,PDF 第 15 页,原文:“Of monthly active users, 19% have never used data analysis, 14% have never used reasoning, and 12% have never used search.” — fetched 2026-10-20
- OpenAI — The state of enterprise AI: 2025 report(发布页日期 2025-12-08),Intercom 案例,PDF 第 17 页,原文:“customers are seeing Fin Voice resolve 53% of calls end-to-end on average” — fetched 2026-10-20
- OpenAI — The state of enterprise AI: 2025 report(发布页日期 2025-12-08),BBVA 案例,PDF 第 20 页,原文:“automates more than 9,000 queries annually and has enabled BBVA to redeploy the equivalent of 3 FTE” — fetched 2026-10-20
- OpenAI — The state of enterprise AI: 2025 report(发布页日期 2025-12-08),结论,PDF 第 23 页,原文:“The primary constraints for organizations are no longer model performance or tooling, but rather organizational readiness.” — fetched 2026-10-20
- OpenAI — Measuring the performance of our models on real-world tasks(GDPval,2025-09-25),任务规模 — fetched 2026-10-20
- OpenAI — GDPval 发布文章,速度和成本的说明 — fetched 2026-10-20
- OpenAI — GDPval 论文,任务时长,PDF 第 2 页,原文:“Tasks require an average of 7 hours of work for an expert professional to complete.” — fetched 2026-10-20
- OpenAI — GDPval 论文,首批结果,PDF 第 6 页,原文:“47.6% of deliverables by Claude Opus 4.1 were graded as better than (wins) or as good as (ties) the human deliverable.” — fetched 2026-10-20
- OpenAI — GDPval 论文,表 2:不同审核策略下的速度和成本改善(gpt-5 一行:Naive 90x,Try nx 1.39x;成本 Try nx 1.63x;gpt-4o 一行 Try nx 0.46x),PDF 第 15 页,原文:“When incorporating time to review and redo work, the payoff from using a model shrinks.” — fetched 2026-10-20
- OpenAI — GDPval 论文,失败的严重程度,PDF 第 15 页,原文:“roughly 29% of ratings were for bad or catastrophic (with roughly 3% of failures marked as catastrophic)” — fetched 2026-10-20
- OpenAI — Introducing GPT-5.2(2025-12-11) — fetched 2026-10-20
- OpenAI — AI in the Enterprise(PDF,未标日期),第一条经验,PDF 第 5 页,原文:“Use a systematic evaluation process to measure how models perform against your use cases.” — fetched 2026-10-20
- OpenAI — AI in the Enterprise(PDF,未标日期),Morgan Stanley,PDF 第 7 页,原文:“access to documents has jumped from 20% to 80%” — fetched 2026-10-20
- OpenAI — AI in the Enterprise(PDF,未标日期),Indeed,PDF 第 10 页,原文:“deliver similar results with 60% fewer tokens.” — fetched 2026-10-20
- OpenAI — AI in the Enterprise(PDF,未标日期),BBVA,PDF 第 16 页,原文:“In five months, BBVA employees created over 2,900 custom GPTs” — fetched 2026-10-20
- OpenAI — Identifying and scaling AI use cases(PDF,未标日期),三类机会,PDF 第 6 页,原文:“focus on common workplace challenges in these three key areas” — fetched 2026-10-20
- OpenAI — Identifying and scaling AI use cases(PDF,未标日期),六类基本用例(名称列在第 11 页),PDF 第 10 页,原文:“Most use cases fall into one of six” — fetched 2026-10-20
- OpenAI — Identifying and scaling AI use cases(PDF,未标日期),影响和投入矩阵,PDF 第 26 页,原文:“Quick wins with strong impact and low effort” — fetched 2026-10-20
- OpenAI — Identifying and scaling AI use cases(PDF,未标日期),每季度重新打分,PDF 第 28 页,原文:“Re-evaluate this scoring each quarter” — fetched 2026-10-20
- OpenAI — Identifying and scaling AI use cases(PDF,未标日期),拆解工作流,PDF 第 30 页,原文:“Encourage power users to break workflows into individual tasks” — fetched 2026-10-20
- OpenAI — A practical guide to building agents(PDF,未标日期),何时值得做智能体,PDF 第 6 页,原文:“Otherwise, a deterministic solution may suffice.” — fetched 2026-10-20
- OpenAI — A practical guide to building agents(PDF,未标日期),选模型,PDF 第 8 页,原文:“build your agent prototype with the most capable model for every task to establish a performance baseline.” — fetched 2026-10-20
- OpenAI — A practical guide to building agents(PDF,未标日期),先用足单个智能体,PDF 第 16 页,原文:“Our general recommendation is to maximize a single agent” — fetched 2026-10-20
- OpenAI — A practical guide to building agents(PDF,未标日期),人工介入,PDF 第 31 页,原文:“Actions that are sensitive, irreversible, or have high stakes should trigger human oversight” — fetched 2026-10-20
- OpenAI — Building an AI-Native Engineering Team(页面未标日期),角色分工 — fetched 2026-10-20
- OpenAI — Building an AI-Native Engineering Team,测试先行 — fetched 2026-10-20
- OpenAI — Building an AI-Native Engineering Team,代码审查 — fetched 2026-10-20
- OpenAI — How People Use ChatGPT(工作论文,2025-09-15;只统计消费者版),PDF 第 3 页,原文:“Writing is the most common use case at work, accounting for 40% of work-related messages” — fetched 2026-10-20
- OpenAI — 客户案例:Morgan Stanley(页面未标日期) — fetched 2026-10-20
- OpenAI — 客户案例:Morgan Stanley,回归测试 — fetched 2026-10-20
- OpenAI — 客户案例:Klarna(页面未标日期;数字取自上线第一个月) — fetched 2026-10-20
- OpenAI — 客户案例:Cisco(2026-05-27) — fetched 2026-10-20
- OpenAI — From assistance to execution: How enterprises put AI to work(2026-08-12) — fetched 2026-10-20
- OpenAI — From assistance to execution,给管理者的建议 — fetched 2026-10-20
- OpenAI — How frontier firms are pulling ahead(2026-05-06) — fetched 2026-10-20
- OpenAI — How frontier firms are pulling ahead,领先企业的做法 — fetched 2026-10-20
- OpenAI — Building more with GPT-5.1-Codex-Max(2025-11-19),长时间运行 — fetched 2026-10-20
- OpenAI — Building more with GPT-5.1-Codex-Max(2025-11-19),压缩 — fetched 2026-10-20
- OpenAI — Building more with GPT-5.1-Codex-Max(2025-11-19),沙箱默认设置 — fetched 2026-10-20
- OpenAI — Building more with GPT-5.1-Codex-Max(2025-11-19),部署前审查 — fetched 2026-10-20
- OpenAI — Building more with GPT-5.1-Codex-Max(2025-11-19),Codex 审查不能替代人 — fetched 2026-10-20
- OpenAI — How agents are transforming work(2026-06-25),超过一小时的任务 — fetched 2026-10-20
- OpenAI — How agents are transforming work(2026-06-25),脚注 2,时长门槛由模型估算 — fetched 2026-10-20
- OpenAI — Harness engineering: leveraging Codex in an agent-first world(2026-02-11),PR 数量 — fetched 2026-10-20
- OpenAI — Harness engineering: leveraging Codex in an agent-first world(2026-02-11),单次运行时长 — fetched 2026-10-20
- OpenAI — Harness engineering: leveraging Codex in an agent-first world(2026-02-11),AGENTS.md 当目录 — fetched 2026-10-20
- OpenAI — Harness engineering: leveraging Codex in an agent-first world(2026-02-11),看不到的知识等于不存在 — fetched 2026-10-20
- OpenAI — Harness engineering: leveraging Codex in an agent-first world(2026-02-11),人审 PR 不是必须 — fetched 2026-10-20
- OpenAI — Harness engineering: leveraging Codex in an agent-first world(2026-02-11),低吞吐环境 — fetched 2026-10-20
- OpenAI — Harness engineering: leveraging Codex in an agent-first world(2026-02-11),不能直接推广 — fetched 2026-10-20
- OpenAI — Harness engineering: leveraging Codex in an agent-first world(2026-02-11),清理 AI slop 的时间 — fetched 2026-10-20
- OpenAI — Introducing the Agents API(2026-09-10),发布文章 — fetched 2026-10-20
- OpenAI — API 文档:Agents API(页面未标日期),托管的职责 — fetched 2026-10-20
- OpenAI — API 文档:Orchestration and handoffs(页面未标日期),从一个智能体开始 — fetched 2026-10-20
- OpenAI — API 文档:Orchestration and handoffs(页面未标日期),拆得太早的代价 — fetched 2026-10-20
- OpenAI — API 文档:Orchestration and handoffs(页面未标日期),谁负责最终答复 — fetched 2026-10-20
- OpenAI — Run long horizon tasks with Codex(开发者博客,2026-02-23),25 小时实验 — fetched 2026-10-20
- OpenAI — Run long horizon tasks with Codex(开发者博客,2026-02-23),持久的项目记忆 — fetched 2026-10-20
- OpenAI — Run long horizon tasks with Codex(开发者博客,2026-02-23),实验性质 — fetched 2026-10-20
- OpenAI — API 文档:Background mode(页面未标日期),后台模式 — fetched 2026-10-20
- OpenAI — Shell + Skills + Compaction: Tips for long-running agents that do real work(开发者博客),网络与数据外泄 — fetched 2026-10-20
- OpenAI — A practical guide to building agents(PDF,未标日期),何时拆成多个智能体,PDF 第 16 页,原文:“or consistently select incorrect tools, you may need to further divide your system” — fetched 2026-10-20
- OpenAI — A practical guide to building agents(PDF,未标日期),工具重叠,PDF 第 16 页,原文:“Some implementations successfully manage more than 15 well-defined, distinct tools while others struggle with fewer than 10 overlapping tools.” — fetched 2026-10-20
- xAI — Setting Grok Bot loose on procurement(2026-09-04) — fetched 2026-10-20
- xAI — Setting Grok Bot loose on procurement,闲置席位 — fetched 2026-10-20
- xAI — Setting Grok Bot loose on procurement,审批规则 — fetched 2026-10-20
- xAI — How SpaceXSI is using Grok Bot to scale customer support(2026-09-22) — fetched 2026-10-20
- xAI — How SpaceXSI is using Grok Bot to scale customer support,上线方式 — fetched 2026-10-20
- xAI — How SpaceXSI is using Grok Bot to scale customer support,放权过程 — fetched 2026-10-20
- xAI — Using Grok Bot to detect and respond to incidents(2026-10-20) — fetched 2026-10-20
- xAI — Grok Bot for Enterprise(2026-09-03) — fetched 2026-10-20
- Google(Sundar Pichai) — Google DeepMind: Bringing together two world-class AI teams(2023-04-20) — fetched 2026-10-20
- Google Research — AI in software engineering at Google: Progress and the path ahead(2024-06-06) — fetched 2026-10-20
- Google Research — AI in software engineering at Google,上线原则 — fetched 2026-10-20
- Google Research — Accelerating code migrations with AI(2024-07-18) — fetched 2026-10-20
- Google Research — Accelerating code migrations with AI,省时估计 — fetched 2026-10-20
- Google 工程师(arXiv 论文) — Paradis 等,How much does AI impact development speed? An enterprise-based randomized controlled trial(2024-10 提交) — fetched 2026-10-20
- Google 工程师(arXiv 论文) — Paradis 等,同上,摘要中的效应量:约 21% — fetched 2026-10-20
- Google(Sundar Pichai) — Q3 2024 earnings call remarks(2024-10-29) — fetched 2026-10-20
- Google(Sundar Pichai) — Cloud Next 2026 演讲稿(2026-04-22) — fetched 2026-10-20
- Google DeepMind — AlphaEvolve: A Gemini-powered coding agent for designing advanced algorithms(2025-05-14) — fetched 2026-10-20
- Google DeepMind — DeepMind AI reduces Google data centre cooling bill by 40%(2016-07-20) — fetched 2026-10-20
- Google Workspace — Google Workspace extends Gemini benefits to more customers(2024-09-24) — fetched 2026-10-20
- Google Workspace — 同上,脚注中的方法说明 — fetched 2026-10-20
- Google Cloud — 1,302 real-world gen AI use cases(最后更新 2026-04-22),Macquarie Bank 条目 — fetched 2026-10-20
- Google Cloud — 同上,Virgin Voyages 条目 — fetched 2026-10-20
- Google Cloud — 同上,CME Group 条目 — fetched 2026-10-20
- Google Cloud — 同上,Deloitte 条目 — fetched 2026-10-20
- iTnews — Macquarie Bank saves 130,000 hours in seven months of Gemini Enterprise use(2026-04-29) — fetched 2026-10-20
- Virgin Voyages — Virgin Voyages 新闻稿:超过 1,500 个 AI 智能体(2026-03-09) — fetched 2026-10-20
- Google Cloud — ROI of AI 2025 摘要文章(2025-09-04;问卷对象 3,466 名高管) — fetched 2026-10-20
- 深圳市人民政府网站(信息来源:福田区) — 福田区以DeepSeek为引擎加快政务智能化转型 70名AI“数智员工”上岗(2025-02-18) — fetched 2026-10-20
- Journal of Medical Internet Research(PMC 全文) — DeepSeek 在中国医院部署情况的范围综述(J Med Internet Res 2025;27:e80770) — fetched 2026-10-20
- Journal of Medical Internet Research(PMC 全文) — 同上,关于医院自报效果的结论 — fetched 2026-10-20
- Glean — Waldo 发布文章(最后更新 2026-04-28) — fetched 2026-10-20
- Thinking Machines Lab 网站(作者为 Bridgewater AIA Labs 研究人员) — Learning to replicate expert judgment in financial tasks(2026-06-30) — fetched 2026-10-20
- CMA CGM — AI Now Summit 新闻稿(2026-05-27) — fetched 2026-10-20
- Reuters(gCaptain 转载) — CMA CGM and French AI startup target customer service(2025-04-06) — fetched 2026-10-20
- 智谱(港交所披露易) — 招股章程(2025-12-30),PDF 第 185 页,原文:“achieves an AI automation rate exceeding 50% in Q&A on new financial regulations” — fetched 2026-10-20
- 智谱(港交所披露易) — 2026 年中期业绩公告(2026-08-31),PDF 第 12 页,原文:“have not yet generated material revenue” — fetched 2026-10-20
- MiniMax(港交所披露易) — 2026 年中期业绩公告(2026-08-26),PDF 第 2 页,原文:“Revenue from our Open Platform and other AI-based enterprise services increased by 703.1%” — fetched 2026-10-20
- Mistral AI — 客户案例:Cisco(页面未标日期) — fetched 2026-10-20
- Mistral AI — 客户案例:SAP(页面未标日期) — fetched 2026-10-20
- Mistral AI — 客户案例:European Patent Office(页面未标日期) — fetched 2026-10-20
- European Patent Office — 新闻稿(2026-03-11) — fetched 2026-10-20
- Mistral AI — 客户案例:Capgemini(页面未标日期) — fetched 2026-10-20
- Cohere — 客户案例:CoreWeave(2026-02-03) — fetched 2026-10-20
- Sakana AI — 三井住友銀行の提案書作成 AI(2026-04-30) — fetched 2026-10-20
- Sakana AI — 三菱UFJ銀行 AI 融資エキスパート(2026-03-06) — fetched 2026-10-20
- Thinking Machines Lab — Tinker 页面(2026-10-15 版本) — fetched 2026-10-20
- Aleph Alpha — 官网首页 — fetched 2026-10-20
- Safe Superintelligence — 官网首页 — fetched 2026-10-20